
Para quem é este guia
Este guia é para quem já usa assistentes de IA no dia a dia e quer dar o próximo passo: integrar modelos a sistemas próprios, comparar APIs com execução local e entender o que muda quando a IA vira componente de software. Não é um curso de programação — é um mapa do terreno, com os termos, os riscos e os atalhos que evitam os erros mais caros.
Aqui, a IA deixa de ser um produto que você usa e passa a ser uma peça do que você constrói. Isso muda as responsabilidades: quem integra passa a responder por chaves de acesso, custo por uso, tratamento de erros, qualidade das respostas e proteção dos dados que entram e saem do sistema. O modelo continua sendo um modelo: ele pode errar, inventar e interpretar instruções de forma inesperada. A diferença é que agora o erro acontece dentro de um fluxo que você controla — e pelo qual você responde.
Se algum conceito parecer novo, o glossário explica termo por termo; os guias de IA local e IA na nuvem detalham os dois lados da execução; e os fundamentos mostram o que acontece por trás de uma resposta.
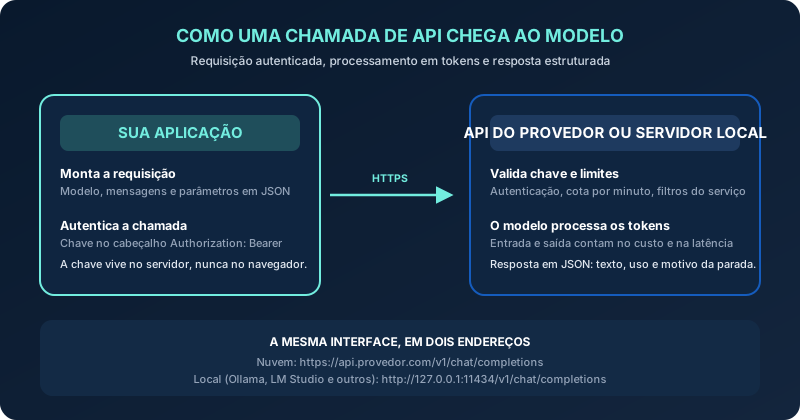
API: do seu programa até o modelo
API (application programming interface) é a interface que permite a um programa solicitar funções de outro. Uma API de IA recebe uma entrada estruturada — geralmente JSON enviado por HTTPS — e devolve uma saída estruturada: o texto gerado, o consumo de tokens, o motivo da parada e outros metadados. Em vez de digitar em um chat, o seu código envia a mensagem e recebe a resposta para continuar o trabalho sozinho.
Assinatura de chat não é a mesma coisa que chave de API. São produtos, faturas e contratos separados em quase todos os provedores. Integrar por API também não significa que o provedor deixa de ver os dados: o que muda é o contrato, a configuração e quem controla a chamada. A página de IA na nuvem detalha as perguntas sobre dados que você deve fazer antes de enviar a primeira requisição.
A anatomia de uma chamada
Uma chamada típica tem quatro partes: o endereço do serviço, o cabeçalho de autenticação, o corpo com o modelo e as mensagens, e os parâmetros de geração. Em formato neutro, sem provedor específico:
curl https://api.exemplo.com/v1/chat/completions \
  -H "Authorization: Bearer $CHAVE_DA_API" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "modelo-exemplo",
    "messages": [{"role": "user", "content": "Resuma este texto em uma frase."}]
  }'
A resposta volta com o texto gerado e o consumo — tokens de entrada e de saída. Custo e latência crescem com o tamanho da entrada, da saída e das ferramentas acionadas, não só com o número de mensagens. Uma conversa longa reenviada inteira a cada chamada custa mais: parte do trabalho de engenharia é decidir o que realmente precisa ir no contexto.
Tokens, limites e retry
Cada pedaço de texto é dividido em tokens antes de ser processado; a mesma palavra pode virar mais ou menos tokens conforme o idioma e o modelo. Provedores cobram por token (ou equivalente) e impõem limites por minuto, por dia ou por valor gasto. Aplicações robustas tratam o limite como parte do fluxo: reduzem a frequência, enfileiram, tentam de novo com espera progressiva (backoff) e registram o erro em vez de escondê-lo.
Leia a página de limites e preços da oferta exata que você usa, no dia em que for usar. Esses números mudam sem aviso longo, e a tabela publicada ontem pode não valer para o plano de hoje.
Compatibilidade “estilo OpenAI”
Muitos serviços e runtimes locais — Ollama, LM Studio, Groq, OpenRouter e outros — expõem o mesmo formato /v1/chat/completions para facilitar a troca de provedor. Isso permite escrever o cliente uma vez e apontar para endereços diferentes, inclusive http://127.0.0.1:11434 na sua própria máquina.
Compatibilidade de formato não é compatibilidade de comportamento: o mesmo modelo pode não existir no outro serviço, parâmetros podem ser ignorados e os limites serão diferentes. Teste a chamada no destino antes de assumir que funciona.
Chaves são dinheiro
- Nunca coloque chave em código que vá para repositório público ou para o navegador. Use variáveis de ambiente ou um cofre de segredos.
- Limite o escopo de cada chave por projeto e acompanhe o consumo com alertas de gasto.
- Rotacione chaves periodicamente e revogue imediatamente qualquer uma que tenha vazado.
Uma chave vazada vira fatura: ferramentas que varrem repositórios públicos atrás de segredos agem em minutos. Quem publica código é o responsável pelo que a chave fizer até ser revogada.
IA na nuvem além do chat
Além da API “pura”, existem plataformas gerenciadas: Vertex AI (Google Cloud), Amazon Bedrock (AWS), Azure AI (Microsoft) e Model Studio (Alibaba Cloud). Elas adicionam catálogo de modelos, escolha de região, rede privada, guardrails, monitoramento e contratos empresariais. Você troca parte do controle direto por menos peças para operar — e por uma fatura mais complexa de prever.
Outro caminho é a inferência serverless de modelos abertos: serviços como Hugging Face Inference Endpoints, Together AI ou Groq hospedam pesos abertos (Llama, Qwen, Mistral, DeepSeek e outros) e cobram por uso. É uma alternativa para rodar modelo aberto sem comprar GPU, mantendo a operação com o provedor.
Fine-tuning como serviço permite adaptar um modelo a um comportamento específico sem manter a infraestrutura de treinamento. Ajuste fino não é anexar documentos: é treinar com exemplos de entrada e saída desejada. Para consultar documentos atualizados, o caminho costuma ser RAG — detalhado na seção para desenvolvedores.
Contratos importam mais do que a marca. Confira residência e retenção de dados, uso para treinamento, nível de serviço e o que acontece quando um modelo é descontinuado. A página de IA na nuvem reúne as perguntas sobre dados para fazer antes de contratar.
IA local como parte da arquitetura
IA local não precisa ser só um chat no seu PC. Os mesmos runtimes que rodam um modelo na sua máquina podem expor uma API local, no estilo OpenAI, para os seus próprios programas consumirem: o Ollama escuta em 127.0.0.1:11434 por padrão, o LM Studio tem modo servidor e o llama.cpp oferece um servidor HTTP. O seu código não sabe a diferença entre chamar a nuvem e chamar a sua máquina — só o endereço muda.
Isso permite fluxos híbridos: tarefas internas e dados sensíveis em modelo local; na nuvem, tarefas que exigem o modelo mais capaz, multimodal, ou picos de demanda. O híbrido só preserva a separação se você definir, no código e na configuração, o que pode sair da máquina e o que não pode. Sem essa fronteira explícita, “híbrido” vira “tudo vai para a nuvem mesmo”.
Modelos locais também produzem embeddings — representações numéricas usadas em busca semântica e RAG — e existem modelos locais de transcrição (Whisper) e de geração de imagem. A limitação continua sendo memória e velocidade do equipamento; o ganho continua sendo controle e previsibilidade de custo. O guia de IA local mostra por onde começar e quais famílias de modelos testar.
Não exponha o servidor de inferência local diretamente à internet. Se precisar de acesso em rede, configure autenticação e restrições de acesso — VPN ou rede interna, no mínimo. Um servidor aberto permite que terceiros usem o seu hardware para gerar texto às suas custas.
Para desenvolvedores
Se você vai escrever código, estas são as peças que aparecem em quase todo projeto com IA. A ordem sugerida é a de custo crescente: comece pela API direta e adicione orquestração quando a tarefa realmente pedir. Cada camada extra é uma camada para depurar.
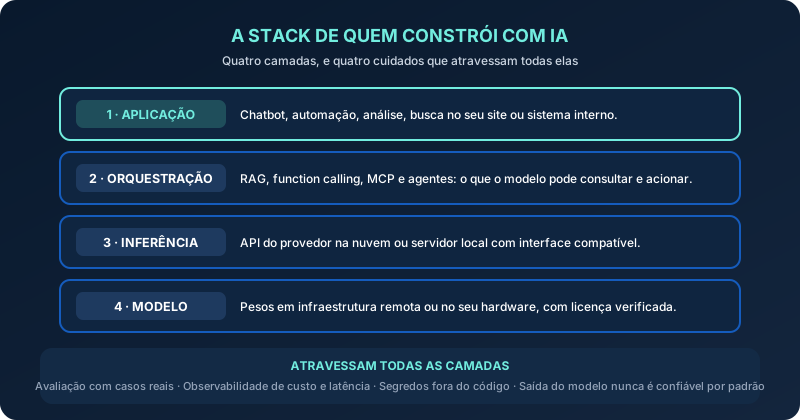
Primeiro passo: uma chamada que você controla
Antes de frameworks, teste a chamada na mão. Isso ensina o formato, os erros e onde o tempo é gasto. Em Python, com o mínimo necessário:
import os
import requests

resposta = requests.post(
    "https://api.exemplo.com/v1/chat/completions",
    headers={"Authorization": f"Bearer {os.environ['CHAVE_DA_API']}"},
    json={
        "model": "modelo-exemplo",
        "messages": [{"role": "user", "content": "Resuma em uma frase."}],
    },
    timeout=60,
)
resposta.raise_for_status()
print(resposta.json()["choices"][0]["message"]["content"])
A chave vem do ambiente, nunca do arquivo. O timeout existe porque a resposta pode demorar ou nunca chegar. O raise_for_status transforma erro de HTTP em exceção explícita — falha barulhenta é melhor do que resposta vazia silenciosa.
RAG: quando o modelo precisa dos seus documentos
RAG (retrieval-augmented generation) recupera trechos relevantes de uma coleção e os inclui na entrada do modelo. O fluxo: dividir documentos em trechos → gerar embeddings de cada trecho → guardar em um banco vetorial → buscar por similaridade a cada pergunta → montar o contexto → gerar a resposta com indicação dos trechos usados.
A qualidade do RAG depende mais da recuperação do que do modelo: se o trecho certo não é encontrado, o modelo não o inventa — ele responde sem ele. Teste com perguntas reais, compare os trechos recuperados com o que você esperava e exija citação de trecho na resposta quando a tarefa for sensível. Recuperação ruim não se conserta trocando de modelo.
Function calling: deixe o modelo acionar funções
Com chamadas de ferramentas, o modelo decide pedir a execução de uma função que você definiu — consultar um pedido, criar um rascunho, agendar um envio — e o seu código executa. O modelo não executa nada sozinho: a execução é sempre do seu sistema, que pode aceitar, recusar ou pedir confirmação.
Defina o esquema da função com clareza e trate os argumentos do modelo como não confiáveis: valide antes de executar e exija confirmação humana para ações irreversíveis — envio, compra, exclusão. Um parâmetro mal interpretado não pode virar uma ação real.
MCP e agentes: autonomia com limites
MCP (Model Context Protocol) padroniza como aplicações de IA se conectam a ferramentas e fontes de contexto. Conectar um servidor MCP dá acesso ao que ele expõe — revise permissões como revisaria uma extensão de navegador. Agentes são sistemas que combinam modelo, ferramentas e um ciclo de execução para avançar em uma tarefa. A autonomia é uma escolha de projeto, não um padrão obrigatório: defina permissões mínimas, orçamento, condições de parada e revisão humana para ações importantes.
Conteúdo externo pode conter instruções maliciosas (prompt injection): dados vindos da web ou de documentos não devem ganhar autoridade sobre a tarefa. O guia de uso responsável aprofunda o que conferir antes de dar autonomia a um agente.
Avaliação e observabilidade
Avalie com casos reais do seu domínio, não só com impressões. Monte um conjunto pequeno de exemplos com resposta esperada, rode após cada mudança de prompt ou modelo e registre: custo por tarefa, tempo de resposta, taxa de erro e casos que exigem revisão humana. Logs ajudam a investigar falhas, mas não devem guardar dados sensíveis — registre o suficiente para depurar, nada além.
Checklist antes de colocar no ar
- Chaves e segredos fora do código, com escopo mínimo e alerta de gasto.
- Timeout, retry com backoff e tratamento de limite de taxa.
- Saída do modelo validada antes de virar ação: HTML escapado, SQL parametrizado, argumentos checados.
- Conjunto de avaliação com casos reais e métrica de custo por tarefa.
- Dados sensíveis fora do prompt — ou rota local explícita para eles.
- Plano de queda: o que o sistema faz quando a API falha ou o modelo é descontinuado.
Um primeiro projeto de fim de semana
Um projeto pequeno ensina mais do que semanas de leitura. O objetivo não é lançar um produto: é atravessar o fluxo completo uma vez, da primeira chamada à medição.
- Escolha uma tarefa pequena e mensurável — por exemplo, classificar e resumir uma lista fixa de textos.
- Faça uma chamada de API simples, com a chave vinda de variável de ambiente, nunca do código.
- Trate timeout e erro: defina um tempo máximo de espera e registre a falha em vez de escondê-la.
- Monte 10 casos de teste reais e anote acertos e erros, um a um.
- Meça o custo por tarefa concluída, incluindo tentativas repetidas.
- Se quiser comparar, repita o mesmo fluxo com Ollama local e anote as diferenças de custo, latência e qualidade.
Com esse roteiro concluído, você tem números seus para decidir. O catálogo de modelos ajuda a escolher por onde começar.
API, nuvem ou local: como decidir
Não existe caminho universalmente melhor: existe o caminho que resolve a sua tarefa com o menor risco aceitável. A tabela compara os quatro arranjos mais comuns.
| Critério | API de provedor | Plataforma gerenciada | Runtime local | Híbrido |
|---|---|---|---|---|
| Controle de dados | Conforme contrato; opt-out pode existir. | Contratos, regiões e auditoria. | Dados não saem da sua infraestrutura. | Depende da rota definida para cada dado. |
| Custo | Por token ou uso; cresce com o tráfego. | Uso + serviços; contratos empresariais. | Equipamento, energia e manutenção. | Custo fixo local + variável na nuvem. |
| Capacidade máxima | Modelos de fronteira do provedor. | Catálogo e serviços do provedor. | Limitada pela memória e CPU/GPU do equipamento. | O melhor de cada lado, com mais complexidade. |
| Esforço de operação | Baixo no código; você opera custos e chaves. | Médio; muita coisa já vem pronta. | Alto: downloads, atualizações, segurança. | Alto: duas infraestruturas para manter. |
| Offline | Não. | Não. | Sim, após os downloads. | Parcial, conforme a rota. |
| Quando escolher | Prototipar rápido e escalar sem hardware. | Empresa com exigências de compliance. | Dados sensíveis, custo previsível, sem internet. | Tarefas sensíveis misturadas com tarefas difíceis. |
Qualquer um dos arranjos exige o mesmo básico: chaves protegidas, tratamento de erro, avaliação com casos reais e revisão humana proporcional à consequência. A escolha da infraestrutura não substitui esses cuidados — ela muda onde eles acontecem.
Links e referências úteis
Documentação oficial é a fonte que você consulta quando o comportamento importa. Reunimos os pontos de entrada mais usados, por camada:
APIs e plataformas
OpenAI — referência da API ↗
Anthropic — documentação ↗
Google AI — API Gemini ↗
DeepSeek — documentação da API ↗
Mistral AI — documentação ↗
Plataformas de nuvem
Google Cloud — Vertex AI ↗
AWS — Amazon Bedrock ↗
Microsoft — serviços de IA ↗
Alibaba Cloud — Model Studio ↗
Links oficiais mudam com frequência; este guia aponta para a documentação, não para páginas de preço. Para fichas de ferramentas, consulte o catálogo; para renomeações e encerramentos confirmados, a página de novidades.
Perguntas sobre APIs e desenvolvimento
Posso usar a camada gratuita de uma API em produção?
Não trate cota gratuita como plano de produção: limites por minuto, fila e mudanças de política são comuns. A camada gratuita serve para aprender a chamada e prototipar. Quando o app tem usuários reais, contrate a oferta e monitore o consumo.
“Compatível com OpenAI” significa que posso trocar de provedor sem mudar nada?
O formato pode ser o mesmo, mas modelos, parâmetros aceitos, limites e preços são diferentes. Troque o endereço, rode o mesmo conjunto de avaliação e confira o comportamento antes de migrar.
Qual modelo devo escolher para o meu projeto?
Teste com a sua tarefa, no seu idioma e com os seus dados de exemplo. Compare custo por tarefa concluída, latência e taxa de erro — não só benchmark. Comece pelo modelo mais simples que resolva a tarefa e suba de categoria apenas se os testes justificarem.
IA local aguenta produção?
Depende da carga, do hardware e da exigência de qualidade. Para volume interno e dados sensíveis, sim, com servidor dedicado e monitoramento. Para pico imprevisível ou tarefas que exigem o modelo mais capaz, a nuvem costuma ser mais simples.
O que fazer se uma chave de API vazar?
Revogue imediatamente no painel do provedor, gere uma nova, coloque-a no cofre de segredos e investigue o uso feito no intervalo. Se a chave estava em repositório público, apague também do histórico do git e trate qualquer segredo próximo como comprometido.
